Ollama
Ollama é um software de código aberto que permite executar modelos de IA populares, como Llama 3.2 ou Gemma 2.
Este é um guia passo a passo sobre como instalar e configurar o Ollama para o ONLYOFFICE Docs.
Requisitos do sistema
Os requisitos de hardware para o Ollama dependem do tamanho do modelo que você pretende executar:
| Tamanho do modelo | RAM |
|---|---|
| 7B | 8 GB |
| 13B | 16 GB |
| 70B | 64 GB |
É necessário pelo menos 4 GB de espaço em disco para o binário do Ollama. Espaço adicional é necessário para armazenar modelos, que podem variar de vários GB a centenas de GB, dependendo do modelo.
Uma GPU dedicada é recomendada para um desempenho aceitável. Executar apenas no CPU é possível, mas resultará em tempos de resposta significativamente mais lentos.
Conectando e configurando o Ollama
-
(Opcional) Instale o Homebrew se essa for sua maneira preferida de gerenciar pacotes no macOS e Linux:
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" -
Para instalar o Ollama, execute o seguinte comando:
curl -fsSL https://ollama.com/install.sh | shPara Homebrew, execute o seguinte comando:
brew install ollamaUma vez instalado, o Ollama disponibiliza comandos para servir, listar, inspecionar e executar modelos em sua máquina.
-
Siga estas etapas para configurar o Ollama:
-
Inicie o servidor de IA local executando o seguinte comando no Terminal:
export OLLAMA_ORIGINS=http://*,https://*,onlyoffice://* -
Inicie o Ollama agora e reinicie na inicialização:
brew services start ollama -
Alternativamente, se um serviço em segundo plano não for necessário, execute o seguinte comando:
ollama serve
-
-
Baixe o modelo que você gostaria de usar em outra janela do Terminal. Por exemplo, para instalar e executar o Llama 3.2:
ollama run llama3.2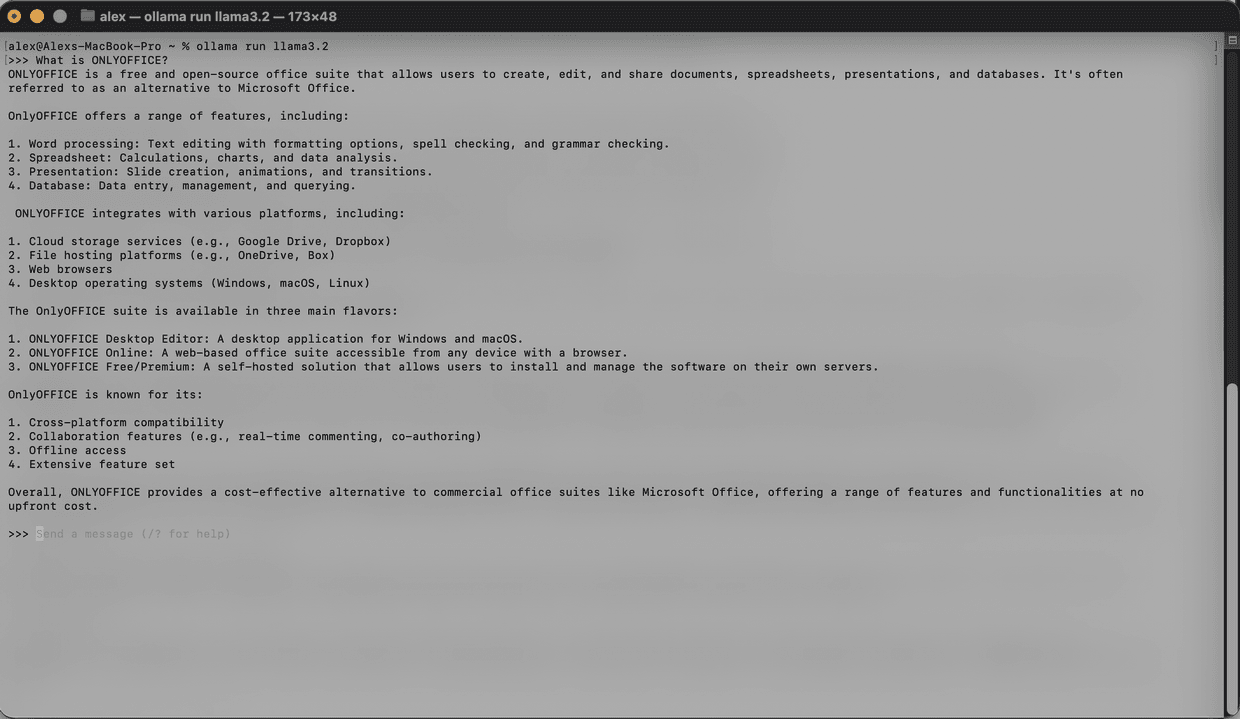
O modelo será baixado e iniciado localmente. O número total de modelos instalados é ilimitado. Para a lista de modelos disponíveis, consulte a documentação oficial do Ollama.
Antes da instalação, certifique-se de que sua máquina possui memória e espaço em disco suficientes para os modelos.
-
Siga este guia para a configuração geral do plugin de IA.
-
Uma vez que o plugin esteja instalado, adicione modelos de IA. Vá para a aba IA e abra Configurações.
-
Selecione Editar modelos de IA no canto inferior esquerdo da janela e clique em Adicionar.
-
Na janela que aparece, selecione Ollama como o provedor e defina a URL para
http://localhost:11434.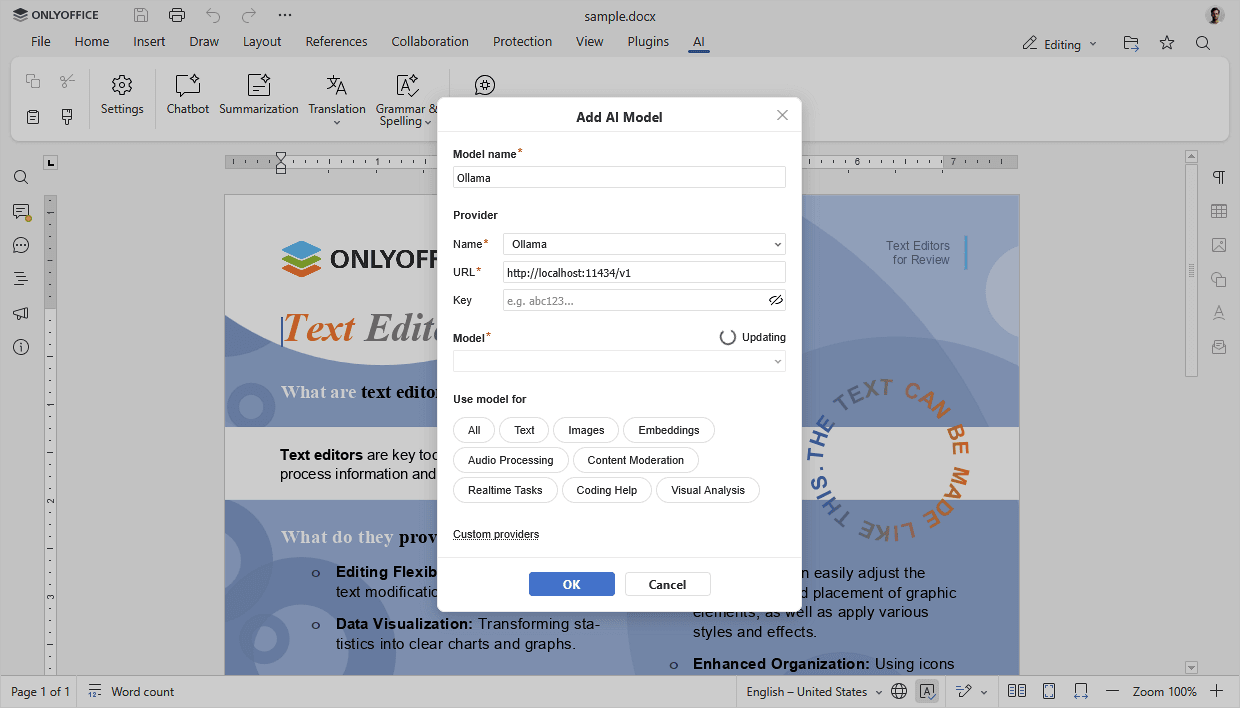
-
Selecione o modelo instalado (por exemplo,
llama3.2:latest) na lista suspensa e confirme. -
Na linha de ícones, selecione o modelo usado para: texto, imagens, embeddings, processamento de áudio, moderação de conteúdo, tarefas em tempo real, ajuda com codificação e análise visual.
-
Clique em OK e feche a janela. O modelo aparecerá na lista de modelos disponíveis na lista de modelos de IA.
-
Atribua diferentes tarefas à IA. Na lista suspensa, selecione os modelos de IA instalados que executarão essas tarefas.
-
Acesse os recursos de IA através da aba IA ou selecionando texto e clicando com o botão direito para abrir o menu de contexto.