Ollama
Ollamaは、Llama 3.2やGemma 2などの人気AIモデルを実行できるオープンソースソフトウェアです。
このガイドでは、ONLYOFFICE Docs用にOllamaをインストールし、設定する手順を説明します。
システム要件
Ollamaのハードウェア要件は、実行するモデルのサイズに依存します:
| モデルサイズ | RAM |
|---|---|
| 7B | 8 GB |
| 13B | 16 GB |
| 70B | 64 GB |
Ollamaバイナリには少なくとも4 GBのディスクスペースが必要です。モデルを保存するための追加スペースも必要で、モデルによっては数GBから数百GBに及ぶことがあります。
許容できるパフォーマンスを得るためには専用GPUの使用を推奨します。CPUのみでの実行も可能ですが、応答時間が大幅に遅くなります。
Ollamaの接続と設定
-
(オプション) macOSおよびLinuxでパッケージ管理を行う際にHomebrewを使用する場合は、以下のコマンドでインストールします:
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" -
Ollamaをインストールするには、以下のコマンドを実行します:
curl -fsSL https://ollama.com/install.sh | shHomebrewを使用する場合は、以下のコマンドを実行します:
brew install ollamaインストールが完了すると、Ollamaはモデルの提供、リスト表示、検査、実行のためのコマンドを提供します。
-
Ollamaを設定するために、以下の手順に従います:
-
ターミナルで以下のコマンドを実行してローカルAIサーバーを起動します:
export OLLAMA_ORIGINS=http://*,https://*,onlyoffice://* -
Ollamaを今すぐ開始し、ログイン時に再起動するには:
brew services start ollama -
バックグラウンドサービスが不要な場合は、以下のコマンドを実行します:
ollama serve
-
-
別のターミナルウィンドウで使用したいモデルをプルします。例えば、Llama 3.2をインストールして実行するには:
ollama run llama3.2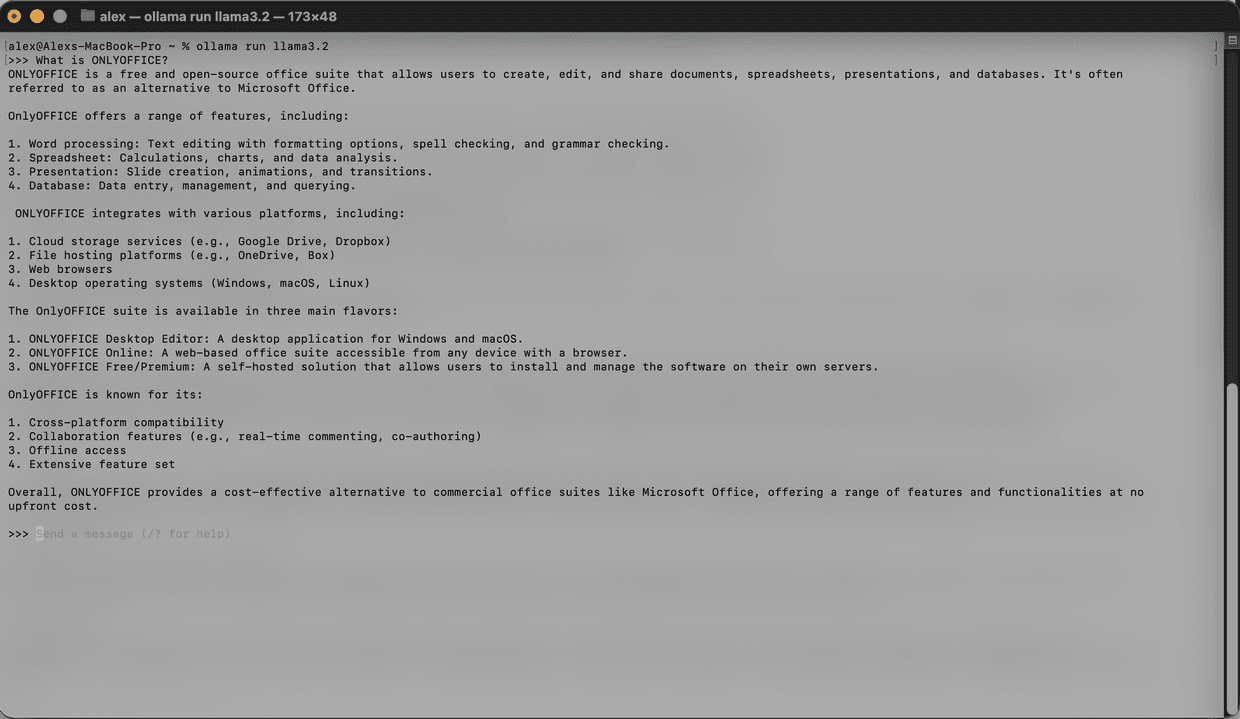
モデルはダウンロードされ、ローカルで開始されます。インストールされたモデルの総数に制限はありません。利用可能なモデルの一覧については、公式Ollamaドキュメントを参照してください。
インストール前に、モデル用に十分なメモリとディスクスペースがあることを確認してください。
-
このガイドに従ってAIプラグインの一般設定を行います。
-
プラグインがインストールされたら、AIモデルを追加します。AIタブに移動し、設定を開きます。
-
ウィンドウの左下にあるAIモデルの編集を選択し、追加をクリックします。
-
表示されるウィンドウで、Ollamaをプロバイダーとして選択し、URLを
http://localhost:11434に設定します。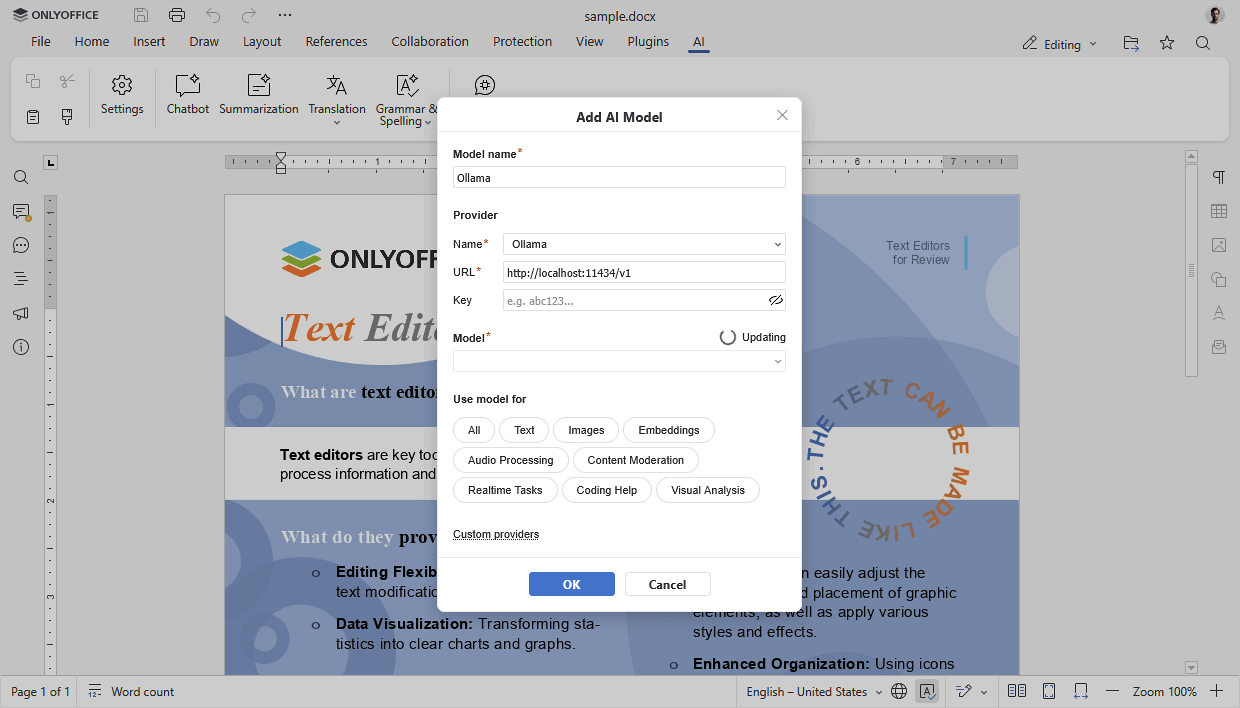
-
インストールされたモデル(例:
llama3.2:latest)をドロップダウンリストから選択し、確認します。 -
アイコンの列で、テキスト、画像、埋め込み、音声処理、コンテンツモデレーション、リアルタイムタスク、コーディング支援、視覚分析に使用するモデルを選択します。
-
OKをクリックしてウィンドウを閉じます。モデルはAIモデルリストに表示されます。
-
AIに異なるタスクを割り当てます。ドロップダウンリストから、これらのタスクを実行するインストール済みAIモデルを選択します。
-
AIタブを通じて、またはテキストを選択して右クリックし、コンテキストメニューを開くことでAI機能にアクセスします。